
Robots.txt и sitemap.xml: как настроить без ошибок
Разберём, какие страницы оставить доступными поиску, а какие исключить из обхода. Покажем примеры для 1С-Битрикс и порядок проверки файлов в Яндекс Вебмастере и Google Search Console.

Robots.txt и sitemap.xml: что настраиваем в первую очередь
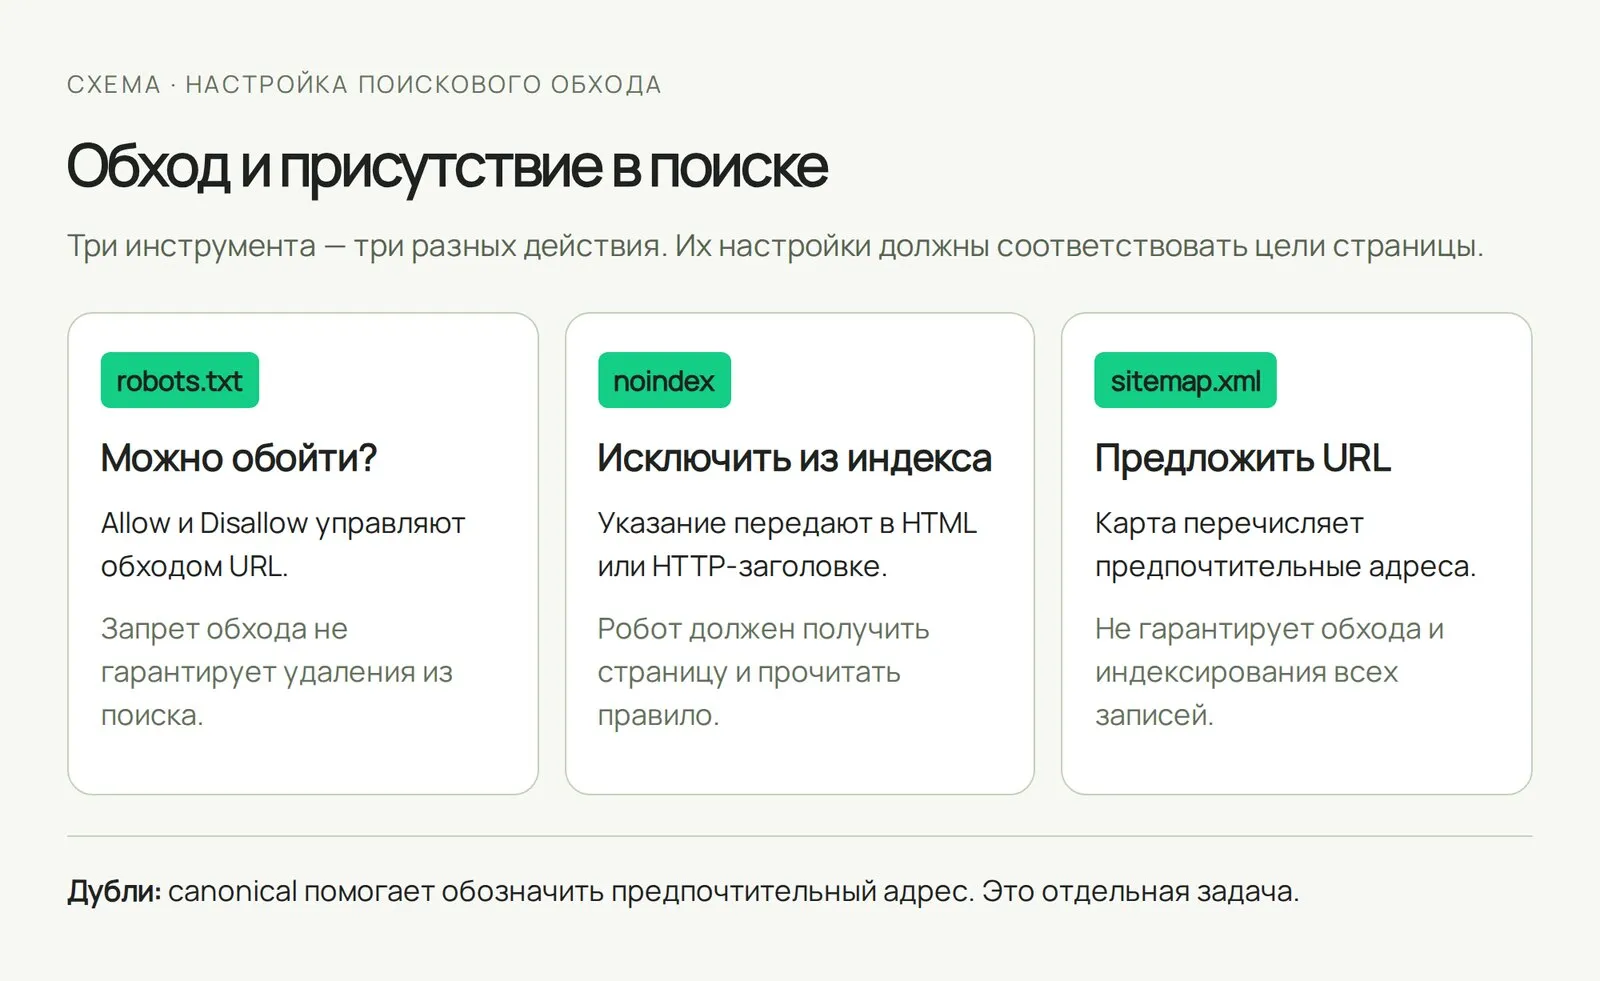
Robots.txt сообщает поисковому роботу, какие адреса можно обходить. Sitemap.xml перечисляет страницы, которые мы хотим предложить поиску. Чтобы настройка работала согласованно, полезные страницы оставляют доступными для обхода и включают в карту, а технические адреса обрабатывают по их назначению. Ни один из этих файлов сам по себе не гарантирует попадания страницы в выдачу.
Начинать лучше со списка типов страниц: услуги, категории, товары, статьи, поиск, личный кабинет, сортировки. Для каждого типа определяем, нужен ли он в поиске и какой адрес считается основным. Это продолжение работы над структурой сайта для SEO: файл с правилами не должен случайно исключать раздел, который вы собираетесь продвигать.
| Инструмент | На какой вопрос отвечает | Чего от него не ждать |
|---|---|---|
| Robots.txt | Разрешён ли роботу обход этого URL? | Гарантированного удаления URL из поиска и защиты информации |
| Noindex | Нужно ли исключить доступную роботу страницу из индекса? | Защиты от просмотра посетителем |
| Rel="canonical" | Какой адрес предпочтителен среди дублей? | Запрета обхода или безусловного выбора указанного адреса |
| Sitemap.xml | Какие URL и сведения об их обновлении мы передаём поиску? | Команды немедленно проиндексировать все записи |
Карта сайта XML — служебный файл для поисковых систем. Оглавление для посетителей решает другую задачу. Навигация нужна независимо от XML: робот должен находить важные страницы и по внутренним ссылкам.
Как читать правила robots.txt
Базовый синтаксис описан в RFC 9309. Файл состоит из групп: строка User-agent указывает робота, а следующие Allow и Disallow задают разрешения и запреты. Каждую инструкцию пишут с новой строки, после имени ставят двоеточие. Комментарий начинается с #. Группы принято отделять пустой строкой, а внутри группы пустых строк быть не должно: справка Яндекса прямо называет их недопустимыми между User-agent, Disallow и Allow.
User-agent: *
Disallow: /service/
Allow: /service/public-guide/

Sitemap: https://example.com/sitemap.xml
Это учебный фрагмент для условного сайта example.com. Он запрещает обход путей внутри /service/, но оставляет доступным /service/public-guide/ и его продолжения. Строка Sitemap сообщает полный адрес карты. Название файла карты может быть другим: требуется указать тот URL, по которому она действительно доступна.
Что означают строки и специальные символы
- User-agent: * — общая группа для роботов, у которых нет своей подходящей группы.
- Disallow: /search/ — запрет обхода URL с таким началом пути; не пароль и не команда удалить результат поиска.
- Allow: — разрешающее исключение внутри выбранной группы правил.
- * в пути — произвольная последовательность символов. Это не полноценный язык регулярных выражений.
- $ — конец URL. Правило /report.pdf$ совпадает только с /report.pdf в корне: /docs/report.pdf и /report.pdf?download=1 под него не попадают. Для PDF на любой глубине нужна маска /*.pdf$, но и она не охватывает URL с параметрами после расширения.
- # — начало комментария: последующий текст строки не становится частью правила.
Сначала робот выбирает подходящую группу, затем сравнивает правила внутри неё. Для Google и Яндекса приоритет имеет более конкретный совпавший путь; при равной специфичности конфликтующих Allow и Disallow преимущество у Allow. Перестановка строк сама по себе проблему не решит. В примере разрешённый префикс длиннее запрещённого, поэтому исключение работает.
Имена директив пишите в привычном виде, а регистр путей проверяйте буквально: /Search/ и /search/ могут означать разное. Значение / после Disallow запрещает обход всего сайта. Пустое значение Disallow такого запрета не создаёт. Случайный слеш после двоеточия — маленькая правка с последствиями для всех публичных разделов.
Где должен лежать файл
Правильное имя — robots.txt, строчными буквами. Размещают его в корне: https://example.com/robots.txt, а не в /catalog/robots.txt. По RFC это текст в UTF-8 с типом text/plain. Проверьте, что по адресу открывается сам файл, а не HTML-страница с сообщением об ошибке. Добиваемся ответа 200 OK. Размер файла — до 500 КБ. Кириллицу в нём не используют: домен .рф в строке Sitemap записывают в Punycode, а кириллические пути — в той кодировке, в которой они реально отдаются сайтом.
Область действия определяется исходным адресом robots.txt: его протоколом, хостом и портом. Даже если робот получил файл после перенаправления на другой хост, по RFC его правила применяются к исходному сайту. У поддомена и другого протокола свой адрес robots.txt, поэтому проверяйте их отдельно. Лишняя цепочка переходов усложняет проверку доступности файла.

Чем robots.txt отличается от noindex
Если URL уже найден поисковиком, запрет обхода не равен удалению из выдачи. Google и Яндекс прямо предупреждают: запрещённый адрес может оставаться в поиске. Робот не скачивает содержимое, но знает о самом адресе, например из ссылок. Поэтому для задачи «страница доступна посетителям, но не нужна в поиске» рассматривают noindex.
Для HTML-страницы директиву можно передать в head:
<meta name="robots" content="noindex">Другой способ — HTTP-заголовок X-Robots-Tag: noindex. Он подходит в том числе для документов, у которых нет HTML-раздела head. В обоих случаях робот должен получить ответ и прочитать указание. Если одновременно закрыть этот URL в robots.txt, он может не увидеть noindex. Добавлять строку Noindex в сам robots.txt вместо метатега нельзя: Google её не поддерживает.
Для дублей нужен ещё один выбор. Если сортировка или метка создаёт копию полезной страницы, предпочтительный адрес можно обозначить canonical. В Google это сигнал выбора основной версии, а noindex полностью исключает страницу из поиска. Эти механизмы не стоит подменять друг другом. Подробнее о полях страницы — в статье про title, description и H1.
Закрытые документы и личные кабинеты защищают правами доступа и авторизацией. Robots.txt открыт для чтения и не мешает человеку обратиться к указанному пути. Проверять безопасность по наличию Disallow неправильно: файл передаёт правила роботам, которые их учитывают, но не управляет разрешениями на сервере.
Яндекс и Google: Clean-param, Host и Crawl-delay
| Директива | Яндекс | |
|---|---|---|
| User-agent, Disallow, Allow | Используются для выбора правил и управления обходом | Используются для выбора правил и управления обходом |
| Sitemap | Указывает адрес карты сайта | Указывает адрес карты или индексного файла |
| Clean-param | Помогает обрабатывать дубли с параметрами без изменения контента | Не поддерживается как директива robots.txt |
| Host | Устарела, робот игнорирует | Не входит в поддерживаемые поля robots.txt |
| Crawl-delay | Больше не учитывается; скорость задают в Вебмастере | Не поддерживается |
Какие параметры можно передать в Clean-param
Clean-param — расширение Яндекса. Оно предназначено для параметров, которые не меняют содержимое: например, меток партнёрских ссылок. Имена перечисляют через амперсанд, а после пробела можно указать префикс пути. Для условного каталога, где параметры ref и from отмечают партнёрский переход и не влияют на страницу, строка выглядит так:
Clean-param: ref&from /catalog/При таком правиле Яндекс может свести варианты одного URL с этими метками к адресу без них. Посетителя строка никуда не перенаправляет. Если параметр выбирает другой товар, меняет состав выдачи или язык, считать его незначимым нельзя. Сравните страницы без параметра и с ним до сохранения правила, включая содержимое и ссылки.
Распространённые метки аналитики — utm_source, utm_medium, utm_campaign, ysclid, yrclid — Яндекс может отбрасывать автоматически, отдельная строка для них не нужна: в Вебмастере такие URL отмечаются как исключённые директивой Clean-param.
Особенно осторожно обращайтесь с пагинацией и фильтрами. Страница ?PAGEN_1=2 может показывать другие товары, а полезный фильтр — отдельную посадочную страницу. Удалять такой параметр через Clean-param лишь потому, что он стоит после вопросительного знака, неверно. В Google страницы пагинации рассматриваются отдельно; сводить canonical всей серии к первой странице не рекомендуется.
Для Google Clean-param не решит задачу дублей. Проверьте canonical, постоянные внутренние ссылки на предпочтительный адрес и состав sitemap. Для ненужных вариантов сортировки в Google можно отдельно выбрать noindex или ограничение обхода; для Яндекса сначала оцените Clean-param. Выбор зависит от цели и от того, известны ли варианты поиску; не нужно автоматически включать все методы одновременно.
Не потеряйте общие правила при создании отдельной группы
Clean-param — межсекционная директива Яндекса: ради неё не требуется отдельный User-agent: Yandex. Если же отдельную группу создать, Яндекс не добавит к ней запреты из *. Google тоже не объединяет общую группу со своей подходящей именованной группой. Поэтому при раздельной настройке в каждой группе должен быть полный предназначенный ей набор правил.
В старых шаблонах встречаются Host и Crawl-delay. Сейчас ими нельзя управлять ни главным зеркалом Яндекса, ни паузой Googlebot. Для неглавных зеркал Яндекс рекомендует постраничные 301-перенаправления, а скорость его обхода настраивается в Вебмастере. Поля «Главное зеркало (Host)» и «Интервал между запросами (Crawl-delay)» в генераторе robots.txt 1С-Битрикс остались, но поддержку директив поисковиками это не подтверждает.

Пример robots.txt для сайта на 1С-Битрикс
В официальном учебном примере 1С-Битрикс есть запреты для /bitrix/, /search/, /auth/, /personal/ и служебных действий. Это отправная точка для проверки, а не файл, который следует переносить целиком. Урок посвящён старому способу ручной настройки и также содержит советы, которые нужно сверять с актуальными справками поисковиков.
Ниже — наш учебный вариант для условного сайта example.com. Предполагаем, что поиск расположен в /search/, авторизация — в /auth/, кабинет — в /personal/. Параметры sort и order меняют только сортировку, print создаёт печатную копию, clear_cache — служебный запрос, ref и from отмечают партнёрский переход и не меняют страницу. Если на вашем сайте их роль или название другое, строки нужно изменить или убрать.
User-agent: *
Disallow: /bitrix/
Allow: /bitrix/*.css$
Allow: /bitrix/*.css?
Allow: /bitrix/*.js$
Allow: /bitrix/*.js?
Disallow: /search/
Disallow: /auth/
Disallow: /personal/
Disallow: /*?sort=
Disallow: /*&sort=
Disallow: /*?order=
Disallow: /*&order=
Disallow: /*?print=
Disallow: /*&print=
Disallow: /*?clear_cache=
Disallow: /*&clear_cache=
Clean-param: ref&from /catalog/

Sitemap: https://example.com/sitemap.xml
Один параметр может стоять первым после ? или следующим после &. Поэтому в примере показаны обе формы, а не только ?sort=. Маска начинается с /, затем * допускает предшествующий путь и другие части URL. Мы намеренно не запрещаем все адреса с вопросительным знаком: среди них могут оказаться полезные страницы и необходимые ресурсы.
Для Яндекса у параметров-дублей есть альтернатива: его справка советует закрывать такие адреса через Clean-param, а не Disallow, — тогда робот сводит их к адресу без параметра и передаёт ему накопленные показатели. Если параметр не меняет содержимое (например, print выводит ту же страницу для печати), рассмотрите Clean-param: print вместо пары Disallow. Учтите: если адрес закрыт Disallow, Clean-param для него уже не сработает — Disallow приоритетнее.
Запрет /bitrix/ дополнен исключениями для CSS и JavaScript внутри этого пути. Это ещё не полный список ресурсов каждого проекта. По фактическим запросам страницы проверьте изображения, шрифты и другие зависимости; при необходимости добавьте точные разрешения. Внешний вид и содержимое должны оставаться понятными роботу после применения правил.
В исключениях $ завершает URL, а ? разрешает параметры после расширения, например main.css?v=2. Без такого уточнения маска /bitrix/*.js разрешила бы также /bitrix/tools/data.json, а /bitrix/*.css — /bitrix/tools/file.css.php. Правила сопоставляют строки URL, а не проверяют тип файла; для каждого исключения проверьте и нужный ресурс, и похожий служебный адрес.
Не закрывайте целиком /upload/ и /local/ по названию папки. Там могут находиться публичные изображения, шаблоны, стили и скрипты. В старом учебном примере есть запрет /upload/, но переносить его без анализа содержимого нельзя. Аналогично не стоит разрешать всё внутри /bitrix/ ради одного файла: найдите нужные ресурсы и задайте достаточные исключения.
Корзину, оформление заказа, сравнение и дополнительные страницы поиска разберите отдельно по их реальным адресам. Универсальных /cart/ или /order/ для каждого сайта нет. Если задача — убрать уже известный поиску URL, примените порядок работы с noindex из предыдущего раздела. Если задача — ограничить обход служебного сценария, проверьте соответствующий Disallow.
Где редактировать в административной части
В документации 1С-Битрикс указан путь: Маркетинг → Поисковая оптимизация → Настройка robots.txt. Выберите нужный сайт, изучите текущие правила и сохраните копию перед изменениями. «Стартовый набор» предлагает стандартные ограничения, а вкладка редактирования позволяет изменить текст вручную. Итог обязательно проверьте по публичному адресу /robots.txt без входа в админку.
Генератор — одна из возможностей 1С-Битрикс. Шаблон, доработанные компоненты и собственные URL проекта могут потребовать других правил.
Как устроена карта сайта XML
Минимальная XML-карта содержит корневой элемент urlset с пространством имён протокола и записи url. В каждой записи обязателен loc — полный адрес страницы с протоколом и доменом. Кодировка файла — UTF-8. Карта может перечислять главную, разделы и отдельные материалы; в примере адреса условные, их нельзя переносить на рабочий сайт буквально.
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://example.com/</loc>
  </url>
  <url>
    <loc>https://example.com/catalog/</loc>
    <lastmod>2026-10-20</lastmod>
  </url>
  <url>
    <loc>https://example.com/articles/site-navigation/</loc>
    <lastmod>2026-10-24</lastmod>
  </url>
</urlset>
Здесь даты — пример формата, а не рекомендация поставить всем страницам указанные значения. Пространство имён с http в xmlns — идентификатор стандарта, его не заменяют на https вслед за адресами сайта. При этом в loc указывают фактические предпочтительные URL страниц, в нашем примере — с https.
Включайте в карту адреса, которые хотите видеть в поиске: доступные, с полезным содержимым, без противоречащего noindex и запрета обхода. Редиректы заменяйте конечными URL, удалённые страницы исключайте. Если один материал открывается по нескольким адресам, согласуйте sitemap с canonical и внутренними ссылками. Карта с разными версиями одного дубля передаёт неоднозначный выбор.
Лимиты: 50 000 URL и 50 МБ
По протоколу sitemaps.org в одной карте допускается не более 50 000 URL и 50 МБ в несжатом виде. В первоисточнике указано: «no more than 50,000 URLs» и «50MB (52,428,800 bytes)». Проверяют оба ограничения: файл может превысить размер раньше, чем число записей. Сжатие gzip не увеличивает допустимый размер распакованной карты.
При превышении любого лимита список делят на несколько файлов. Можно разделить его раньше: например, выделить товары, категории и статьи для удобства проверки. Более быстрый обход это не гарантирует.
Символы внутри XML экранируют по правилам XML. Например, амперсанд между параметрами URL записывается как &, а после чтения XML соответствует обычному &. Не путайте экранирование XML с кодированием символов самого URL. Сохранённый файл должен разбираться XML-парсером, а не только красиво открываться в браузере.

Lastmod и индексный sitemap: что обновлять
Lastmod в записи страницы — дата её последнего изменения, а не время очередной генерации карты. Google использует это значение, если оно последовательно соответствует реальным обновлениям. Справка рекомендует отражать существенное изменение: основного содержимого, структурированных данных или ссылок. Перестановка даты в подвале сама по себе не повод обновлять lastmod у всего сайта.
Для статьи ориентируйтесь на содержательную правку материала. Для карточки товара заранее определите, какие изменения основных данных должны отражаться в карте. Проверьте, какую дату реально отдаёт генератор: дата сохранения служебной настройки может не совпадать с изменением публичной страницы. Если надёжной даты нет, необязательный lastmod лучше не заполнять выдуманным значением.
Поля priority и changefreq необязательны. Google их игнорирует. Яндекс, по его справке о Sitemap, учитывает priority при очерёдности загрузки страниц, поэтому, если заполняете поле, выделяйте им действительно важные разделы: приоритет сравнивается только внутри вашего сайта, и единица у всех страниц ничего не меняет. На позиции в выдаче поле не влияет. Сначала добейтесь правильного набора URL и достоверного lastmod.
Индексный файл перечисляет карты, а не страницы
Для нескольких XML-карт используют sitemapindex. Его записи sitemap содержат loc с адресами дочерних карт. Это другой уровень структуры: страницы лежат в urlset дочернего файла, а не непосредственно в sitemapindex. Например, карта каталога и карта блога могут быть объединены так:
<?xml version="1.0" encoding="UTF-8"?>
<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <sitemap>
    <loc>https://example.com/sitemap-catalog.xml</loc>
  </sitemap>
  <sitemap>
    <loc>https://example.com/sitemap-articles.xml</loc>
  </sitemap>
</sitemapindex>
Необязательный lastmod внутри sitemapindex, если вы его добавляете, относится к изменению соответствующего файла карты. Он не заменяет даты страниц внутри неё. В robots.txt и панели поиска можно указать адрес самого индекса. При проверке откройте и его, и дочерние файлы: доступный индекс со ссылками на несуществующие карты не выполняет свою задачу.
Как настроить генерацию sitemap в 1С-Битрикс
Используйте штатную настройку карты сайта в разделе поисковой оптимизации. В форме задают адрес карты, выбирают файлы и папки, инфоблоки, их разделы и элементы. Состав берут из подготовленного списка публичных страниц. Не отмечайте все доступные пункты без разбора: в карте нужны адреса для поиска, а не перечень всего, что хранится в CMS.
- Выберите нужный сайт и в поле «Адрес карты сайта» проверьте протокол и домен: по ним формируются ссылки в карте.
- Настройте включение обычных файлов и папок. Проверьте, не попали ли служебные страницы.
- Для инфоблоков отдельно проверьте включение списка, разделов и элементов, а также шаблоны их публичных URL.
- Включите автогенерацию там, где она нужна. По документации эта опция обновляет карту при создании, изменении или удалении элементов и разделов инфоблока.
- Запустите генерацию и откройте полученные файлы. При использовании опции добавления правила в robots.txt проверьте результат и уберите устаревшие адреса карт.
Автогенерация инфоблока не доказывает, что карта правильно обновляется после любого собственного обработчика или обмена. Сделайте приёмочную проверку: опубликуйте тестовый материал, измените его публичный адрес на тестовой копии, затем удалите. На каждом шаге посмотрите результат генерации. Статические файлы проверьте отдельно — они не равны элементам инфоблока.
Проверку карты включите в задачи технической поддержки сайта после смены домена, шаблонов URL, настроек каталога или механизма обмена.

Проверка в Яндекс Вебмастере и Search Console
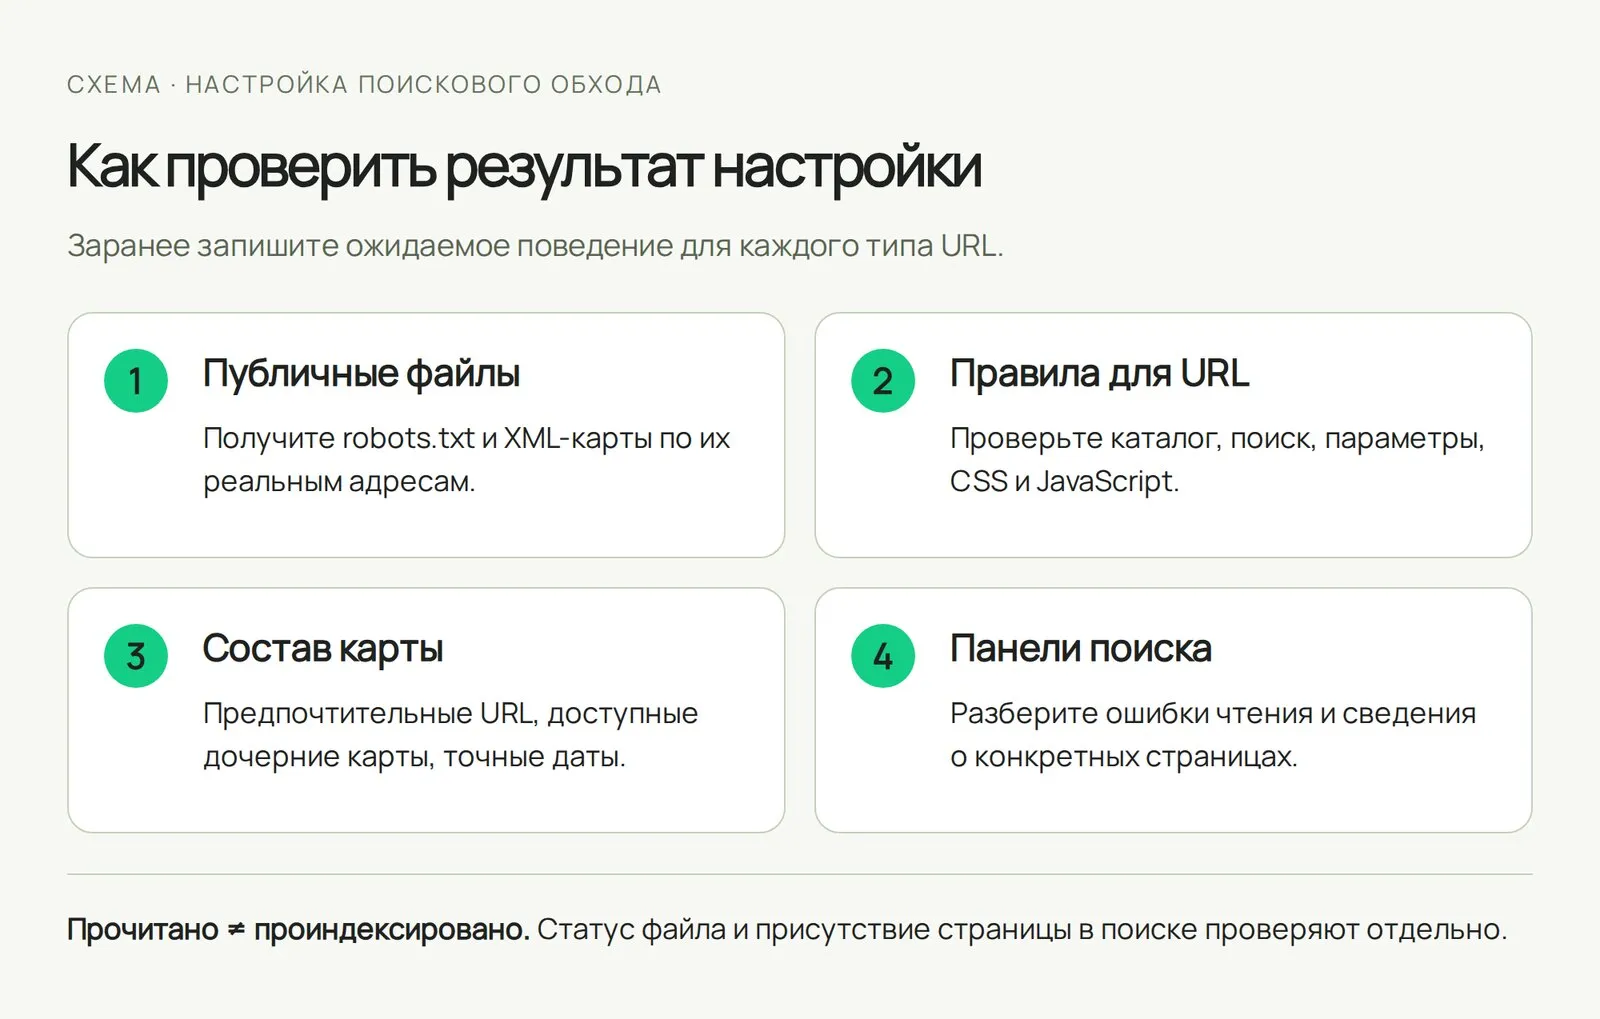
Мы проверяем результат на конкретных URL. Отсутствие синтаксической ошибки ещё не означает, что выбранные пути соответствуют вашей задаче. Подготовьте примеры из каждой группы страниц и заранее запишите ожидаемый результат. После этого сравнивайте ожидание с правилами и ответами сервера.
| Учебный URL | Что ожидаем в примере выше |
|---|---|
| /catalog/item/ | Обход разрешён; при выборе страницы для поиска она есть в карте |
| /search/?q=desk | Обход запрещён правилом /search/ |
| /catalog/?sort=price | Обход запрещён; то же проверяем, когда sort стоит не первым |
| /catalog/?PAGEN_1=2 | Нет автоматического запрета только из-за пагинации |
| /bitrix/cache/css/site/main.css | Обход разрешён исключением для CSS |
| /sitemap.xml | Файл доступен роботу; если это индекс, доступны и его дочерние карты |
Таблица описывает ожидаемое действие учебных правил, а не результат проверки вашего сайта. Добавьте в неё реальные URL изображений, скриптов, важных посадочных страниц и служебных сценариев. Обязательно включите адрес, который должен оставаться открытым рядом с запрещаемым разделом: так легче заметить слишком широкую маску.
В Яндекс Вебмастере
- Откройте Инструменты → Анализ robots.txt. Можно проверить полученный с сайта файл или вставить подготовленный текст до его установки.
- Изучите учитываемые правила и ошибки, включая разбор строки Clean-param. В блоке проверки доступа к страницам проверьте действие Allow и Disallow на реальных URL. Для Clean-param отдельно сравните содержимое страниц с параметрами и без них: проверка разрешения обхода не подтверждает объединение дублей.
- На странице «Файлы Sitemap» укажите полный адрес карты или индекса и добавьте его. После обработки изучите статус и сообщения об ошибках.
- При исправлении существующей карты не удаляйте её ради повторной загрузки: проверьте доступность и используйте предусмотренную в сервисе обработку обновления.
В Google Search Console
- В отчёте robots.txt посмотрите обнаруженный файл, дату последнего обхода и ошибки обработки. Отчёт доступен для доменного ресурса либо ресурса с префиксом URL без пути.
- Через проверку URL сопоставьте известную Google версию важной страницы с проверкой текущей страницы. Убедитесь, что обход и индексирование разрешены и нужные ресурсы доступны.
- В отчёте Sitemaps отправьте адрес карты или индекса. Проверьте результат чтения и ошибки обработки.
- После критического исправления robots.txt при необходимости запросите его переобход в соответствующем отчёте. Это не обещание немедленного обхода всех открытых страниц.
Успешная проверка текущей страницы не гарантирует её появления в поиске. Прочитанная карта также не означает, что все перечисленные страницы проиндексированы. Если страница доступна, но не участвует в поиске, изучайте сведения о конкретном URL, выбранный canonical и содержимое. Дальнейший поиск причин удобно вести по плану технического SEO-аудита.
Частые ошибки и чек-лист перед сохранением
| Ошибка | Что проверить и исправить |
|---|---|
| Disallow: / остался после разработки | Снять общий запрет на рабочем сайте и проверить публичные разделы |
| Весь /bitrix/ закрыт без анализа ресурсов | Найти нужные CSS, JS и другие зависимости; добавить достаточные исключения |
| Запрещены все URL с параметрами | Разделить метки, сортировки, пагинацию и полезные фильтры; проверить каждый тип |
| Noindex стоит на недоступной роботу странице | Для исключения из индекса дать роботу прочитать noindex |
| Для Yandex или Googlebot добавлена неполная отдельная группа | Проверить полный набор правил выбранного робота, а не надеяться на наследование из * |
| В sitemap старый домен или редиректы | Обновить генератор и перечислить предпочтительные конечные URL |
| Lastmod ежедневно меняется у всех страниц | Связать его с реальными изменениями или убрать необязательное поле |
| В панели успешно прочитан только индекс карты | Открыть дочерние XML и выборку перечисленных страниц |
Перед изменением сохраните старые файлы и список причин для каждой правки. После сохранения скачайте публичные версии заново: админка и фактический ответ сайта должны совпадать. Затем пройдите короткий приёмочный список:
- В robots.txt нет общего запрета, затрагивающего нужные публичные страницы.
- Каждое исключение Allow проверено на реальном ресурсе, необходимом странице.
- Указанный в Sitemap адрес открыт; карты укладываются в лимиты и разбираются как XML.
- В карте нет выбранных для исключения страниц, устаревших адресов и служебных вариантов.
- Даты lastmod соответствуют изменениям, а обновление карты воспроизводится после правки контента.
- Вебмастер и Search Console получают нужные версии файлов; ошибки чтения разобраны отдельно от статусов индексирования страниц.
Передайте разработчику URL, ожидаемое поведение, текущее правило и способ проверки. Например: каталог открыт, сортировка закрыта от обхода, CSS доступен, карта содержит конечные адреса.
Частые вопросы
Можно ли обойтись без robots.txt?
Если ограничивать обход не требуется, отсутствие файла само по себе не делает сайт недоступным поиску. Но при служебных разделах и множестве вариантов URL явные проверенные правила удобнее контролировать. Не добавляйте запреты ради наличия файла: каждая строка должна решать понятную задачу.
Обязателен ли sitemap.xml для попадания в поиск?
Нет: Google может обнаруживать страницы по обычным ссылкам. Карта особенно полезна новому или сложному сайту, но не гарантирует обхода и включения всех записей в индекс.
Нужно ли запрещать PAGEN_1 и другие параметры пагинации?
Не автоматически. Сначала проверьте, какие товары и ссылки появляются на следующих страницах и как робот до них добирается. Пагинация отличается от повторной сортировки того же списка. В учебном robots.txt выше общего запрета PAGEN_* нет; решение принимают по структуре конкретного каталога.
Почему карта открывается, а поисковик сообщает об ошибке?
Открытие в вашем браузере не доказывает, что робот получил тот же ответ и разобрал XML. Проверьте статус HTTP, содержимое ответа, синтаксис, лимиты, доступность дочерних карт и запреты обхода. Дальше ориентируйтесь на конкретное сообщение панели, а не на внешний вид файла.
Когда изменения robots.txt и sitemap начнут действовать?
Сохранение на сервере и обработка поисковой системой — разные события. Посмотрите дату последнего получения файла и сообщения панели. Для критического изменения используйте доступный запрос переобхода, но не рассчитывайте на гарантированный срок обновления выдачи. Проверка сайта сразу после правки нужна, даже если робот ещё хранит прежнюю версию.
Источники
- Базовый протокол — IETF, Koster et al., сентябрь 2022, RFC 9309: Robots Exclusion Protocol.
- Интерпретация robots.txt, группы, область действия и поддерживаемые поля — Google Crawling Infrastructure, How Google interprets the robots.txt specification.
- Назначение robots.txt и доступность ресурсов — Google Search Central, Introduction to robots.txt.
- Метатег и HTTP-заголовок — Google Search Central, noindex.
- Каноникализация дублей — Google Search Central, предпочтительные URL; обработка каталога — пагинация и варианты списков.
- Правила Яндекса — использование robots.txt, User-agent, Disallow и Allow, Clean-param.
- Устаревшие директивы — Яндекс, Crawl-delay и официальный пост команды Поиска от 20.03.2018 об отказе от Host.
- XML, лимиты и индекс карт — протокол sitemaps.org; рекомендации Google — создание и отправка sitemap и назначение карты сайта; Яндекс — использование файла Sitemap.
- Документация 1С-Битрикс — управление robots.txt, учебный пример ручного файла, настройки генерации sitemap.
- Проверка в Яндексе — анализ robots.txt и файлы Sitemap.
- Search Console Help — отчёт robots.txt, проверка URL, отчёт Sitemaps.
Обсудим
вашу задачу.
Новый сайт, продвижение или поддержка — начнём с того, что нужно вашему бизнесу.
info@iteraciya.ru
Понравилась статья?